함수 밖의 카운터를 읽고 하나 늘리려다 UnboundLocalError를 보면 변수 이름은 같아도 Python이 다른 지역 변수를 만들었다는 뜻이다. 함수 안에서 대입하는 이름은 기본적으로 지역 변수다.
count = 0

def increment():
count += 1 # 지역 count를 읽기 전에 대입하려고 한다increment()를 호출하면 count += 1의 오른쪽에서 지역 count를 먼저 읽으려다 실패한다. 함수 밖에 같은 이름이 있어도 이 대입 때문에 함수 안의 count는 지역 변수로 취급된다. 오류가 나는 줄에서 count가 어디에서 만들어지는지 추적하는 것이 첫 진단이다.
상태는 반환값으로 전달하는 편이 테스트하기 쉽다
도식의 함수 경계 밖 상태를 직접 바꾸는 대신, 필요한 값을 인자로 받고 새 값을 반환하면 입력과 결과가 드러난다. 같은 증가 동작을 반환값 중심으로 바꿔 보자.
def increment(count: int) -> int:
    return count + 1

count = increment(count)
assert count == 1
assert increment(4) == 5
입력과 출력을 명시하면 함수가 외부 상태에 숨겨서 의존하지 않는다. 테스트마다 전역 값을 초기화해야 하는 문제도 줄어든다.
실패한 예제와 수정한 예제를 같은 파일에 둘 때는 함수를 새로 정의한 뒤 테스트해야 한다. 실패를 확인하려고 한다면 원래 함수를 호출한 지점에서 UnboundLocalError가 나는지만 보고, 수정된 함수는 별도로 두 경로를 검증하자.
global은 최후의 선택이다
정말 모듈 수준 상태를 바꿔야 한다면 global count를 선언할 수 있지만, 여러 호출 경로에서 값이 바뀌면 추적하기 어렵다. 객체로 상태를 캡슐화하거나 호출자가 상태를 소유하도록 설계하는 편이 대부분 더 안전하다. 중첩 함수의 바깥 지역 변수를 바꿀 때는 nonlocal이 별도의 의미를 가진다.
서버 요청처럼 여러 흐름이 같은 상태를 만질 수 있는 곳에서는 모듈 전역 카운터가 저장소를 대신하지 못한다. 프로세스가 둘이면 값도 둘이고, 재시작하면 사라진다. 단순 계산은 인자·반환값으로 끝내고, 공유 상태가 정말 필요할 때는 소유자와 동기화 방법을 따로 정한다.
지역 변수 오류를 재현하고 수정한다
count = 0

def broken():
    count += 1  # UnboundLocalError: 지역 count가 아직 없다

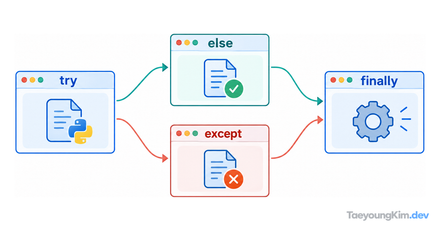
try:
    broken()
except UnboundLocalError:
    pass  # 실패 경로를 확인했다
else:
    raise AssertionError("지역 변수 오류가 나야 한다")

def increment(value: int) -> int:
    return value + 1

assert increment(count) == 1
assert count == 0  # 외부 상태는 바뀌지 않는다
첫 분기에서는 오류가 실제로 발생하는지 확인하고, 다음 분기에서는 반환값과 외부 count가 바뀌지 않았는지 확인한다. global을 추가해 오류만 숨기면 호출 순서에 따라 결과가 달라지는 상태 문제는 남는다.
핵심 요약
함수 안의 대입은 기본적으로 지역 변수를 만든다. 전역 값을 변경하려고 global을 늘리기보다, 값을 인자로 받고 반환하는 함수로 데이터 흐름을 드러내자. 스코프 오류는 이름 문제가 아니라 누가 상태를 소유하는지의 설계 문제일 때가 많다.