

DB/SQL
데이터 모델링, SQL과 NoSQL, 트랜잭션, 인덱스, 정합성과 마이그레이션을 다룹니다.
글 목록
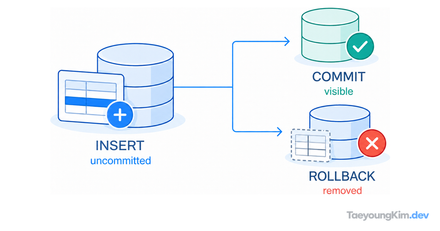
SQL INSERT 후 COMMIT과 ROLLBACK: 트랜잭션을 되돌릴 수 있는 범위
INSERT가 즉시 확정되지 않는 이유와 COMMIT·ROLLBACK의 경계, 테스트 데이터를 안전하게 다루는 순서를 설명합니다.
DB/SQL3 분
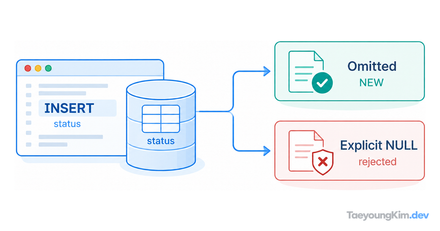
SQL CREATE TABLE의 DEFAULT와 NOT NULL: 새 행의 기본값을 안전하게 설계하는 법
DEFAULT와 NOT NULL이 각각 언제 적용되는지, INSERT에서 NULL과 열 생략이 왜 다른지 예제로 설명합니다.
DB/SQL3 분
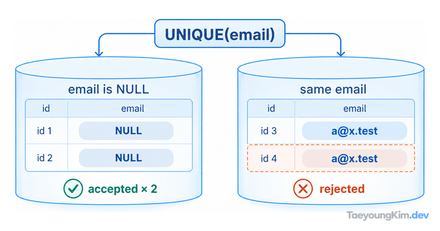
SQL UNIQUE에 NULL이 여러 개 들어가는 이유: PRIMARY KEY와 차이
UNIQUE 제약을 걸었는데 NULL 행은 두 개 저장되고 같은 이메일은 거부됩니다. SQLite 예제로 NULL·빈 문자열·NOT NULL·PRIMARY KEY의 차이를 확인합니다.
DB/SQL4 분
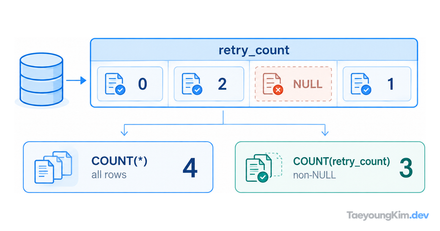
SQL COUNT(*)와 COUNT(컬럼) 차이: NULL은 왜 건수에서 빠질까?
같은 작업 네 건에서 COUNT(*)는 4, COUNT(retry_count)는 3이 되는 이유를 NULL과 0의 차이, WHERE 필터까지 한 예제로 확인합니다.
DB/SQL2 분
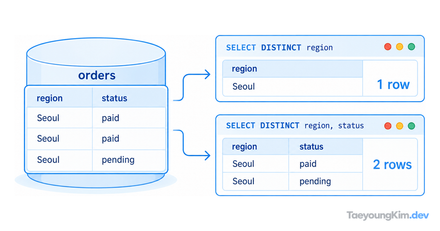
SQL DISTINCT 여러 컬럼 중복 제거: 한 컬럼이 계속 중복되는 이유
DISTINCT를 썼는데 Seoul이 두 줄 남았다면, SQL은 한 컬럼이 아니라 SELECT에 적은 컬럼 조합을 비교하고 있을 수 있습니다. 같은 주문 데이터로 결과를 확인합니다.
DB/SQL3 분
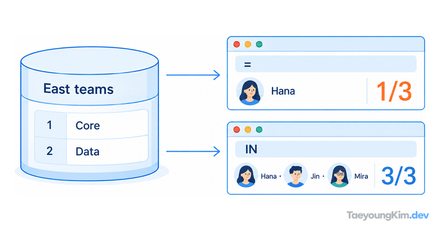
SQL 서브쿼리 =와 IN 차이: 여러 행일 때 조회 결과가 빠지는 이유
서브쿼리가 팀 ID 두 개를 반환하는데 =로 비교하면 직원이 일부만 나올 수 있습니다. 같은 데이터로 단일 값 비교와 IN의 여러 값 비교를 확인합니다.
DB/SQL3 분