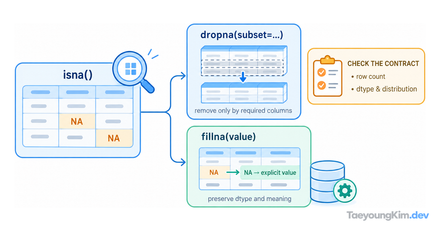
상담 접수는 다섯 건인데 대기시간 집계는 세 건이다. 두 건이 사라진 걸까? groupby().count()는 선택한 열에 값이 있는 건수를 세고, size()는 그룹에 들어온 행 수를 센다. 데이터가 누락됐을 때 두 숫자는 서로 다른 질문의 답이 된다.
size는 행, count는 값이 있는 칸을 센다
도식에서 size는 표의 행을 그대로 세지만 count는 선택한 열의 빈 칸을 건너뛴다. 따라서 차이는 삭제된 행 수가 아니라 그룹 안에서 값이 기록되지 않은 칸의 수다.
설명용 상담 데이터 다섯 행을 만든다. wait_min이 None인 두 건은 접수 사실은 있지만 대기시간을 기록하지 못했다. 0은 빠른 처리로 대기시간이 0분인 유효한 값이다.
import pandas as pd

calls = pd.DataFrame({
    "channel": ["email", "email", "email", "chat", "chat"],
    "wait_min": [12, None, 0, 9, None],
})

summary = calls.groupby("channel").agg(
    received=("wait_min", "size"),
    timed=("wait_min", "count"),
    average=("wait_min", "mean"),
)
print(summary.to_string()) received timed average
channel
chat 2 1 9.0
email 3 2 6.0이메일 세 행 중 None 한 건은 received에는 들어가고 timed에서는 빠진다. 0분은 값이 있으므로 timed에 포함된다. 평균 6.0은 (12 + 0) / 2다. 세 건을 분모로 한 평균 4.0도, 대기시간을 모르는 건을 0분으로 바꾼 결과도 아니다.
숫자가 다르면 원본에서 빠진 칸을 찾는다
먼저 두 집계의 차이를 내고, 어떤 행의 값이 비었는지 확인한다.
summary["missing_time"] = summary["received"] - summary["timed"]
print(summary["missing_time"].to_dict())
print(calls.loc[calls["wait_min"].isna(), ["channel", "wait_min"]])missing_time은 chat: 1, email: 1이다. 두 번째 출력에는 각 채널에서 대기시간이 비어 있는 행이 한 건씩 나온다. 접수 건수와 측정 완료 건수를 함께 보여 주면 읽는 사람이 ‘숫자가 틀렸다’고 착각하지 않는다. 테스트에서는 0, None, 양수를 한 채널에 섞고 received == timed + missing_time이 성립하는지 확인할 수 있다.
그룹 기준 열도 비어 있다면?
여기서는 channel에 빈 값이 없다. 채널 자체가 비어 있는 행이 생기면 그룹 생성 단계에서 그 행을 포함할지 별도로 정해야 한다. count와 size만 바꿔도 빠진 채널 그룹은 되돌아오지 않는다. 집계 전 입력 행 수와 그룹에 포함된 행 수를 비교하는 테스트가 필요한 이유다.
어떤 숫자를 지표 이름에 붙일까
‘채널별 접수 건수’에는 행 수인 size가 자연스럽다. ‘대기시간을 측정한 건수’에는 count가 맞다. 평균 대기시간을 보고할 때는 누락 건수도 옆에 두어 평균의 표본이 얼마나 남았는지 알 수 있게 한다. 누락을 무작정 0으로 채우면 평균이 내려가지만, 0분은 실제 측정값일 수 있으므로 None과 구별해야 한다.
데이터가 커졌을 때 성능을 논하기 전에 먼저 지표 계약을 고정하자. 어떤 행을 접수로 인정하는지, 누락이 왜 생겼는지, 그룹 기준 값이 없는 행은 어떻게 취급하는지가 다르면 빠른 집계도 잘못된 보고서가 된다. 원본이 중복으로 들어왔다면 size와 count 모두 함께 부풀 수 있으니 입력 키의 중복도 확인해야 한다.
핵심 요약: 두 건수는 서로 다른 질문의 답이다
groupby().size()는 그룹의 행 수를, 열의 count()는 결측치가 아닌 값의 수를 센다. 0은 값이므로 빠지지 않는다. 두 수가 다르면 함수부터 바꾸지 말고 빠진 칸과 지표의 뜻을 확인하자.
작성자
기초 개념을 구현과 검증, 실제 운영 판단까지 연결해 기록합니다.