soup.select_one(...).text에서 AttributeError가 나면 .text가 문제라기보다 선택자가 요소를 찾지 못했을 가능성이 크다. select_one은 첫 요소를 찾지 못하면 None을 반환한다. 작은 HTML로 이 경계를 먼저 확인하자.
from bs4 import BeautifulSoup

def read_title(html: str) -> str:
    soup = BeautifulSoup(html, "html.parser")
    title = soup.select_one("h1.article-title")
    if title is None:
        raise ValueError("제목 요소를 찾지 못했습니다")
    return title.get_text(strip=True)

assert read_title('<article><h1 class="article-title">새 글</h1></article>') == "새 글"h1.article-title은 h1 태그이면서 article-title 클래스를 가진 요소를 뜻한다. .text나 get_text()는 선택된 요소에서만 호출해야 한다. 다음처럼 클래스가 바뀐 입력은 실패해야 한다.
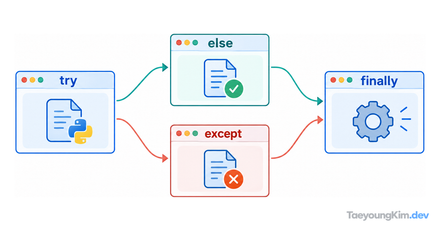
try:
    read_title('<article><h1 class="headline">새 글</h1></article>')
except ValueError as error:
    assert "제목 요소" in str(error)
else:
    raise AssertionError("필수 제목 누락을 감지하지 못했습니다")

soup = BeautifulSoup('<article><h1 class="article-title">새 글</h1></article>', "html.parser")
assert soup.select_one("h2.subtitle") is None  # 선택 항목은 없어도 정상
HTML을 먼저 확인한다
브라우저에서 보이는 화면과 HTTP 요청으로 받은 HTML은 다를 수 있다. JavaScript가 나중에 렌더링한 콘텐츠라면 선택자가 맞아도 응답 본문에는 제목이 없다. 우선 상태 코드와 실제 받은 HTML에 article-title이 있는지 소량만 확인한다. 값이 있는데도 못 찾는다면 선택자의 태그·클래스가 실제 구조와 같은지 살핀다. 원본 응답 전체를 로그에 남기면 개인정보나 세션 정보가 섞일 수 있다.
누락은 오류인지 정상인지 정한다
목록의 일부 항목에 부제목이 없는 것이 정상이라면 그 필드는 None으로 남기고 누락 수를 기록할 수 있다. 반면 필수 제목이 없다면 위처럼 명시적으로 실패시켜야 구조 변경을 알아차린다. 모든 필드를 빈 문자열로 바꾸면 정상적인 빈 값과 수집 실패를 구분할 수 없다.
실제 사이트를 대상으로 실행하기 전에는 수집 허용 범위와 요청 빈도를 확인한다. 이 글의 예제는 네트워크 요청을 하지 않는 문자열 HTML 테스트이므로 선택자 동작만 분리해서 확인할 수 있다. 데이터의 출처·수집 시각이 중요한 경우에는 추출 결과와 함께 보존해야 나중에 구조 변경을 추적하기 쉽다.
핵심 요약
select_one은 결과가 없으면 None을 반환한다. .text를 바로 호출하기 전에 필수·선택 필드를 구분하고, 실제로 받은 HTML과 선택자를 함께 확인하자. 화면 구조가 바뀔 수 있다는 전제로 누락을 관찰하면 크롤러가 조용히 잘못된 데이터를 모으는 일을 막을 수 있다.