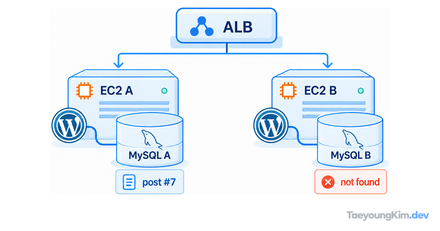
조회 요청이 몰려 DB가 버거워 보인다. RDS에 Multi-AZ를 켜면 인스턴스가 하나 더 생기니 SELECT도 반씩 나눠 처리할 것 같다. 그런데 체감 속도는 그대로다. 설정이 잘못됐다기보다, 대기 인스턴스에 기대한 일이 다를 수 있다.
RDS Multi-AZ인데 SELECT 부하가 그대로인 이유
여기서 말하는 구성은 대기 인스턴스 하나를 두는 Multi-AZ DB 인스턴스 배포다. 기본 인스턴스가 읽기와 쓰기를 받고, 다른 가용 영역의 대기 인스턴스는 데이터를 동기화하며 장애 조치를 준비한다. 평소 애플리케이션의 SELECT가 대기 인스턴스로 가지 않는다.
같은 주문 목록 화면을 떠올려 보자. 사용자가 목록을 열 때마다 기본 DB에 SELECT가 100건 들어오고 있었다면, 대기 인스턴스를 추가해도 조회 요청은 여전히 기본 DB를 향한다. 여기서 100건은 흐름을 설명하기 위한 가상 수치이지 성능 측정값이 아니다. Multi-AZ가 노리는 것은 평상시 조회량 분산보다 기본 DB에 문제가 생겼을 때 서비스가 복구될 경로다.
단, Multi-AZ라는 이름만 보고 모든 구성을 같게 취급하면 안 된다. AWS는 대기 인스턴스 하나를 둔 DB 인스턴스 배포와, 읽기 가능한 인스턴스 둘을 둔 Multi-AZ DB 클러스터 배포를 구분한다. 이 글의 “대기 DB는 SELECT를 받지 않는다”는 설명은 전자에 해당한다. 사용 중인 배포 유형을 먼저 확인해야 하는 이유다. AWS의 Multi-AZ 배포 유형 설명에서 두 유형의 차이를 확인할 수 있다.
Read Replica를 만들면 조회가 자동으로 분산될까?
Read Replica는 기본 DB의 변경 사항을 받아 읽기 요청을 처리하는 별도 인스턴스다. 하지만 복제본을 생성하는 것만으로 애플리케이션의 연결이 자동으로 바뀌지는 않는다. 주문 목록처럼 복제본에서 읽어도 되는 요청을 애플리케이션이 복제본 엔드포인트로 보내야 기본 DB의 조회 부하가 줄어든다.
| 주문 목록 요청 | 연결 대상 | 기대하는 역할 |
|---|---|---|
| 주문 생성·수정 | 기본 DB | 변경 내용을 기록 |
| 변경 직후 주문 확인 | 기본 DB | 방금 쓴 값 확인 |
| 약간 늦게 반영돼도 되는 목록·통계 | 읽기 복제본 | 기본 DB의 읽기 부하 분산 |
세 번째 요청을 복제본으로 보낼 수 있는지는 화면의 요구사항에 달려 있다. Read Replica는 변경 내용을 비동기식으로 받으므로, 주문을 저장한 직후 복제본을 읽으면 잠깐 이전 값이 보일 수 있다. “저장했는데 목록에 없다”는 문제를 만들지 않으려면 즉시 일치해야 하는 조회는 기본 DB에서 처리하거나, 복제 지연을 고려한 제품 동작을 설계해야 한다. AWS의 읽기 복제본 설명도 애플리케이션의 읽기 연결과 비동기 복제를 구분한다.
장애 조치와 읽기 분산을 혼동하면 생기는 일
대기 인스턴스는 기본 DB 장애 시 자동 장애 조치를 위한 구성이다. Read Replica는 평상시 읽기 부하를 나누는 구성이고, 일반적인 DB 인스턴스 읽기 복제본을 기본 DB의 자동 장애 조치 대상과 동일하게 생각해서는 안 된다. 별도로 독립 DB로 승격하는 절차가 있으며, 그때 애플리케이션 연결과 데이터 시점을 확인해야 한다.
둘은 양자택일도 아니다. 장애 대비가 필요하고 읽기 요청도 많다면 대기 인스턴스가 있는 DB 인스턴스에 Read Replica를 추가할 수 있다. 비용과 복제 지연, 연결 라우팅까지 함께 판단해야 한다.
지금 구성에서 무엇을 먼저 확인할까?
RDS 화면에 Multi-AZ: Yes라고 보일 때 바로 “읽기 서버가 하나 늘었다”고 결론 내리지 말자. 다음 순서면 원인을 좁히기 쉽다.
- 배포 유형: 대기 인스턴스 하나를 둔 DB 인스턴스인지, 읽기 가능한 인스턴스가 있는 DB 클러스터인지 확인한다.
- 실제 연결: 목록 조회가 기본 DB와 읽기 복제본 중 어느 엔드포인트로 가는지 애플리케이션 설정을 확인한다. 접속 비밀번호·전체 연결 문자열은 로그에 남기지 않는다.
- 요청의 성격: 쓰기 직후의 확인처럼 즉시 최신 값이 필요한 조회와, 조금 늦어도 되는 통계 조회를 구분한다.
- 관측 결과: 기본 DB의 읽기 부하와 복제본 지연을 전환 전후에 비교한다. 장애 대비가 목적이었다면 조회 속도보다 장애 조치 경로와 복구 시 연결 동작을 따로 점검한다.
실제 RDS 장애 조치나 부하 테스트를 수행한 결과를 이 글의 예시로 제시하는 것은 아니다. 대신 어떤 구성에서 어느 요청이 어디로 가야 하는지 판단하는 기준을 남긴다.
핵심 요약
Multi-AZ DB 인스턴스의 대기 DB는 평소 SELECT를 분산하지 않는다. 장애 대비가 목적이기 때문이다. 읽기 부하를 나누려면 Read Replica를 만들고 적합한 조회를 그쪽으로 라우팅해야 한다. 그때는 비동기 복제의 지연도 함께 다뤄야 한다. 먼저 배포 유형과 실제 DB 연결을 확인하면, “인스턴스가 늘었는데 왜 그대로지?”라는 질문의 답이 보인다.